Matrix 矩阵
矩阵()是人们在解决线性方程组、研究线性变换的过程中,逐渐抽象出来的一种数学工具。
从形式上看,矩阵()就是按照“行”和“列”排列起来的一组数字。例如:
它有 2 行、3 列,所以叫做 2×3 矩阵。在 NumPy 等编程工具中,也记作:
概念:Coefficient matrix 方程的系数矩阵
在线性代数里,一个矩阵最常扮演的角色就是方程组的系数矩阵 ——把方程组里所有未知数前面的系数按位置抄下来,排成的一张表。
比如方程组:
把系数抽出来:每行 = 一个方程,每列 = 一个未知数:
第一列全是 的系数,第二列全是 的系数;未知数 和等号右边的 都被"分离"出去了——矩阵本身只管系数。
这样做的好处是:方程组被拆成了"系数()+ 未知数()+ 结果()“三部分,可以分别研究。有时还会把 也并进来,写成增广矩阵(augmented matrix):
消元法就是在增广矩阵上做行变换。
所以在线性代数中看到一个矩阵,第一反应可以是:它很可能就是某个方程组的系数表。下面"动机"会把这件事完整展开。
动机
为什么要用到矩阵?有两个重要的动机:
动机一:抽象出线性方程组
方程组:
人们把系数、变量、结果分别组织成矩阵 、向量 、向量 :
整个方程组就可以压缩成:
规定运算过程,就是矩阵的每一行成为一个新的向量,与向量 做点积,就还原出原方程:
所以“压缩”不是魔法,而是逐行点积的缩写。
矩阵把一大堆线性方程的共同结构提取出来了。
动机二:描述线性变换
随着人们认知的深入,矩阵被用来表示线性变换(linear transformation)——整个空间按照同一个规则发生的变化。
比如我们规定一个缩放(scaling)规则:
x方向扩大2倍,y方向扩大3倍。
那么原来的点:,就会变成:。要把这个“变化规则”记录下来,可以这样表示:
但数学家希望有一种更加统一、更加方便计算的表达方式。
于是可以写成:
这里同样用到了点积:结果的每个分量,就是矩阵的一行与 的点积。
关键在于这个系数表:
这就是一个矩阵。它还有一个更深刻的读法:矩阵的每一列,就是标准基向量变换后的落点——两列 、 正是 、 被变换后的位置。
这个规则并不是只对这个点有效。任何一个点丢进去,都按照同一个规则变化。我们实际上不是在改变“某一个点”。而是在定义整个空间应该怎么变化。(“线性”体现在:原点保持不动,直线变换后仍然是直线。)这就是为什么我们说:
矩阵可以描述空间的变换。
这时候,“矩阵”和“向量”的关系就非常清楚了。可以把它们想象成:
向量:要描述“某个东西在哪里、是什么状态”
矩阵:我要描述“这个东西怎么变化”
于是:
就是:
按照 规定的变化规则,让 发生变化,成为
两个动机在这里统一了:解方程 ,本质上就是问——“哪个向量 经过变换 之后,恰好落在 ?”解方程其实是变换的逆问题。
这也是线性代数里非常核心的思想。这个"逆问题"的数学化就是 Inverse Matrix 逆矩阵: 的解正是 。
视角:矩阵的每一列是基向量变换后的落点
在介绍具体变换之前,我们需要深刻理解:为什么矩阵的每一列就是基向量变换后的落点? 这是理解线性代数几何直觉的核心。
1. 从基向量拆分向量
在二维坐标系中,任意一个向量 都可以看作是标准基向量 和 的线性组合(Linear Combination):
它的几何意义非常简单:在 方向走 步,在 方向走 步。
2. 线性变换的网格保持性
线性变换(Linear Transformation)最核心的特点是:原点不动,网格线保持平行且等距。
这意味着,当整个空间发生线性变换 时,变换后的向量 ,依然等于原系数 乘以变换后的基向量:
核心结论:我们不需要关心空间里无数个点分别变到了哪里,只要知道基向量 和 落在哪,整个空间中任意一点变换后的位置就彻底确定了!
3. 数学推导:落点如何拼成矩阵
假设经过某种线性变换后:
- 第一基向量 落到了新位置
- 第二基向量 落到了新位置
那么任意向量 变换后的新向量为:
如果我们将这两个落点向量按顺序当作列向量拼成一个矩阵 :
计算矩阵乘以向量 :
把两个标准基向量直接带入验证:
- (提取矩阵第 1 列,正是 的落点)
- (提取矩阵第 2 列,正是 的落点)
4. 简单例子:构造逆时针 90° 旋转矩阵
假设我们要设计一个让整个空间逆时针旋转 90° 的矩阵,不需要记忆繁琐公式,只需要看两个基向量去到了哪里:
- 逆时针旋转 90° 后落到 这是矩阵的第 1 列
- 逆时针旋转 90° 后落到 这是矩阵的第 2 列
把这两列拼在一起,直接写出旋转矩阵:
试着用它旋转点 :
直观来看,点 在第二象限逆时针旋转 90° 确实到了 !
视角: 系数矩阵乘向量的“列组合视角”
一个向量 本质上是在说:一个向量沿着他的各个基向量走多少。 是这个向量的分量。
系数矩阵可以理解为记录每一个标准基向量经过线性变换之后去了哪里。
因为
所以矩阵的第 列就是对应基向量经过变换后的像:
这里的 不一定仍然是一组基向量;只有当这些列向量线性无关时,它们才构成一组新的基。
矩阵乘向量是什么?
原来的向量:
经过矩阵变换:
即:
所以你可以把整个过程想象成:
先分别计算基向量经过变换后的像,再用原向量的坐标系数重新组合这些像。
下面的动画用剪切变换展示这件事。左边是原来的网格和向量
右边是变换后的网格:先看两个基向量的像 、,再沿着这两个新方向分别走 步和 步,最后得到:
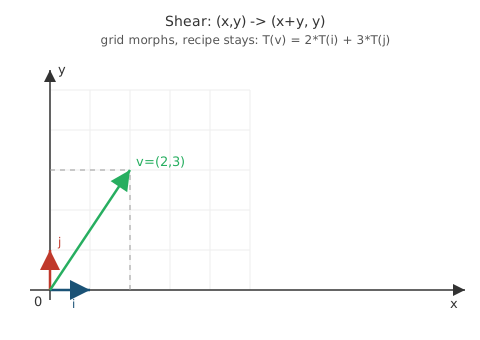
动画中绿色向量的“拼装配方”始终是 和 :改变的是基向量经过变换后的方向和位置,坐标系数并没有改变。
这里是向量被矩阵变换了,坐标系仍然作为参考保持不动。改变的是 基向量的像 ,而不是把坐标系本身搬走。
请结合 深入理解:矩阵变换的几何意义 这篇文章来理解。
运算:一般规则
矩阵加法
两个形状相同的矩阵相加,就是对应位置的数字分别相加:
形状条件:必须是 ,形状不同没法对齐位置,加法无意义。
含义:两个变换的效果叠加。 把矩阵看作"变换机器”, 就是"两台机器各算一遍,再把输出相加":
验证一下。取放大 2 倍的 和剪切 ,输入 :
- 先加矩阵再变换:
- 分别变换再加输出:,,相加也是 ✓
标量乘法
一个数字(标量)乘以一个矩阵,就是乘到每一个元素上:
没有形状限制,任何矩阵都可以。
含义:变换的"力度"整体放大。 把矩阵看作变换机器, 就是"同一套变换规则,但所有输出都被缩放 倍":
从"列 = 基向量落点"的视角看更直观: 的每一列就是原来落点的 倍——基向量的落点全部缩放 倍,整个空间的变换效果自然跟着缩放 倍。
验证一下。取剪切 ,,输入 :
- 先缩放矩阵再变换:
- 先变换再缩放输出:,乘 3 也是 ✓
一个和 行列式 有关的推论:缩放矩阵会放大行列式的缩放倍数, 矩阵有 ——面积/体积的缩放是"每个维度各乘一次 ", 个维度就是 。比如 2 阶矩阵放大 3 倍,面积缩放变成原来的 倍。
矩阵乘法
矩阵的乘法为:
的第 行、第 列的元素 = 的第 行 · 的第 列(点积)
公式:
计算前提、形状条件: 的列数必须等于 的行数,否则行与列长度不同,点积无从谈起:
内侧的两个 “抵消”,留下外侧的 和 。
2×2 矩阵乘法公式的推导
一般地,两个 2×2 矩阵相乘的完整公式:
我们说,两个 2×2 矩阵 、 作用于向量 ,定义为:
表示:
- 先用 变换:
- 再用 变换:
我们希望这个复合效果也能用一个单一的矩阵 来表示,使得:
这个 就是 和 的乘积,记作 。
这个公式是怎么推导出来的?
第一步:先算
这个时候, 看作是一样新的向量。
第二步:把结果代入
按矩阵乘向量的规则展开:
第三步:按 和 合并同类项
第一行:
第二行:
第四步:写成矩阵乘向量的形式
把上面的结果重新写成"矩阵 × 向量":
结论
为了让"先 后 的复合变换"等于"一个单一矩阵的作用",即:
必须是:
一句话总结
矩阵乘法公式不是人为规定的,而是从"变换复合"的需求中自然推导出来的。
运算:常见矩阵变换
既然矩阵的每一列就是基向量变换后的落点,那么想设计任何一种线性变换,只需要回答一个问题:
和 被变换后,分别落到哪里?
把这两个落点作为两列拼起来,就得到了对应的矩阵。下面用这个方法构造几种最常用的变换。
缩放(Scaling)
前面已经见过:x 方向扩大 倍,y 方向扩大 倍。
- 落到
- 落到
旋转(Rotation)
让整个空间绕原点逆时针旋转角度 。
- 旋转后落到
- 旋转后落到
(这正是单位圆上三角函数的定义:角度 处的点是 ;而 在角度 处。)
把两个落点拼成列:
验证一下,旋转 :
结果恰好是 的落点,符合预期。
剪切(Shear)
剪切就像推一叠扑克牌:y 坐标越高的点,x 方向被推得越远(保持 y 不变,x 加上 倍的 y):
看基向量的落点:
- 的 ,不动,还是
- 的 ,被推到
一个正方形经过剪切会变成平行四边形——面积不变,但形状被"推歪"了。
投影(Projection)
把所有点垂直压到 x 轴上:y 坐标直接清零。
基向量的落点:
- 本来就在 x 轴上,不动:
- 被压到原点:
投影是一种"坍缩":整个二维平面被压成一条直线。这也解释了为什么投影矩阵不可逆——无数个点被压到了同一个位置,信息已经丢失,无法还原。
更一般地,投影到任意过原点的直线(方向单位向量为 )的矩阵是:
反射(Reflection)
沿 x 轴翻转:y 坐标取反。
- 不动:
- 翻到
组合变换
这些基本变换可以用矩阵乘法组合起来。例如"先剪切、再旋转 90°":
一个新矩阵就同时完成了两件事——这正是"矩阵乘法 = 变换的复合"的实际用途。
一句话总结
设计变换矩阵不需要背公式:只要想清楚两个基向量去了哪里,把它们写成列,矩阵就出来了。
区分:Matrix 矩阵 VS Vector 向量
形式上 Vector 向量 其实是矩阵的特例 —— 一个 维向量写成竖排,就是一个 的矩阵(叫列向量,column vector);写成横排 ,就是一个 的矩阵(叫行向量,row vector)。
这个"特例"关系不是文字游戏:把矩阵的运算规则套在向量上,刚好还原出向量自己的那些运算——
① 矩阵加法 → 向量加法。 两个 矩阵相加就是对应位置相加:
这正是 向量加法。标量乘法同理。
② 矩阵乘法 → 矩阵乘向量
其实就是 “第二个只有一列的矩阵"的矩阵乘法:形状规则 ,内侧的 抵消;得出的结果为 每个元素 = “行 · 列"的点积” 的向量(一个 的矩阵)。
③ 点积:
向量点积 就是 两个只有一行或一列的矩阵的乘法。行向量()乘列向量(),按形状规则得到一个 矩阵——也就是一个数:
参见:注意:向量可以看作矩阵的特例
角色上:一个是数据,一个是规则
在一个系数矩阵 中两者都是"一堆数字”,但角色完全不同:
| Vector 向量 | Matrix 矩阵 |
|---|
| 角色 | 数据:描述"某个东西在哪里、是什么状态" | 规则:描述"这个东西怎么变化" |
| 形状 | (一列数字)或 | (一张表) |
| 函数类比 | 函数的输入 / 返回值 | 函数本身 |
| 在 里 | 是输入, 是输出 | 是把输入变成输出的"变换机器" |
用输入、输出的语言说:向量是被处理的数据,矩阵是处理数据的规则。
矩阵的形状 带着这个信息:一个 矩阵,吃进去 维向量,吐出来 维向量——乘法的形状规则正好保证了这一点:
比如 矩阵:输入:(3 维),输出:(2 维):
在机器学习里这个分工天天出现:一条数据(一张图、一个词)是向量,而模型的每一层权重就是矩阵——数据从层间流过,每经过一层就是被一个矩阵变换一次。